स्कैन PDF के लिए अलग तरीका क्यों चाहिए
स्कैनर कागज़ के पेजों की तस्वीरें बनाकर उन्हें PDF फ़ाइल में रख देता है। उसके अंदर कोई टेक्स्ट नहीं होता, सिर्फ़ पिक्सेल होते हैं — इसलिए आम PDF एडिटर में किसी शब्द पर क्लिक करने से कुछ नहीं होता। OCR से स्कैन को Word में बदलने पर एडिट होने वाला टेक्स्ट तो मिलता है, लेकिन पेज दूसरे फ़ॉन्ट में दोबारा बनता है और ओरिजिनल का लुक खो जाता है।
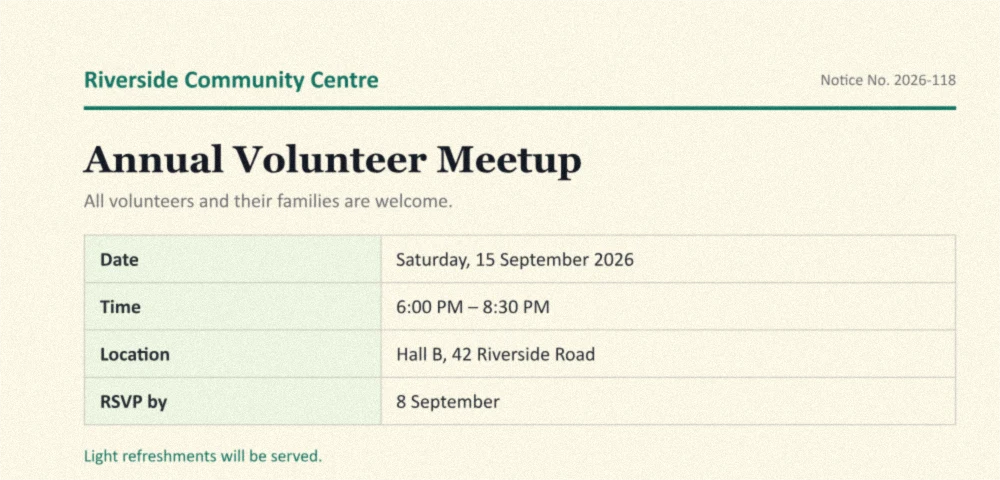
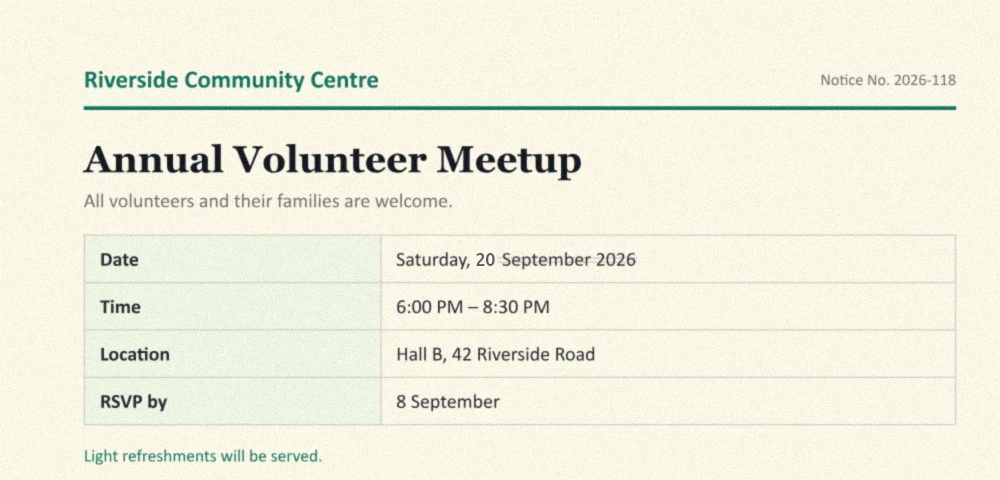
Edit Any Text स्कैन को वैसा ही रखता है। यह टेक्स्ट पहचानता है ताकि पता चले कि हर शब्द कहाँ है, सिर्फ़ वही अक्षर हटाता है जिन्हें आप बदलते हैं, उनके पीछे का कागज़ दोबारा बनाता है और नए शब्द छपे अक्षरों से मिलाकर बनाता है। फिर एडिट किया पेज आपकी PDF के ओरिजिनल पेज की जगह ले लेता है।
स्कैन के लिए टिप्स
- ज़्यादा रिज़ॉल्यूशन वाले स्कैन (300 dpi या ज़्यादा) से टेक्स्ट पहचान और फ़ॉन्ट मिलान बेहतर होता है।
- अंग्रेज़ी के अलावा दूसरी भाषा के डॉक्यूमेंट के लिए एडिटर टूलबार में सही पहचान भाषा चुनें।
- सीधे स्कैन सबसे अच्छे चलते हैं; बहुत टेढ़े पेज पर किसी शब्द को एरिया चुनें से चुनना पड़ सकता है।
एडिट किए गए स्कैन पेज का क्या होता है
टेक्स्ट पहचानने का काम आपके चुने पेज पर, आपके ब्राउज़र में ही, आपकी चुनी भाषा में होता है। बदलाव लागू करने पर वह पेज उसी साइज़ की एक इमेज से बदल जाता है — आपका एडिट किया हुआ स्कैन। PDF के बाकी पेजों को छुआ नहीं जाता।
दो बातें जानना ज़रूरी है। एडिट किया पेज बिना नुकसान वाले PNG के रूप में रखा जाता है, इसलिए फ़ाइल ओरिजिनल, ज़्यादा कंप्रेस्ड स्कैन से बड़ी हो सकती है। और अगर स्कैन में सर्च होने वाले टेक्स्ट की अदृश्य परत थी, तो वह परत एडिट किए पेज से हट जाती है, यानी उसके शब्द अब सेलेक्ट या सर्च नहीं हो सकेंगे। पहचान का सिस्टम छपे हुए अक्षरों के लिए बना है: हाथ की लिखावट और मुहरें भरोसेमंद तरीके से नहीं पहचानी जातीं।
ज़िम्मेदारी से इस्तेमाल
सिर्फ़ वही डॉक्यूमेंट एडिट करें जो आपके हैं या जिन्हें बदलने का आपको अधिकार है। किसी को धोखा देने के लिए स्कैन किए गए आधिकारिक डॉक्यूमेंट — सर्टिफ़िकेट, पहचान पत्र, कॉन्ट्रैक्ट, वित्तीय रिकॉर्ड — बदलना गैरकानूनी है और इसकी अनुमति नहीं है।